ローカル動画生成というと、少し前までは「モデルがVRAMへ収まらないならかなり厳しい」という印象がありました。
ところが最近は、量子化・Dynamic VRAM Loading・CPU Offloadなどが進み、GPUのVRAM容量を超える大型モデルでも現実的に動かせるケースが増えています。
今回は、オープンウェイトで公開された動画生成モデルMiniMax H3を、
RTX 5070 Ti 16GB + RAM 48GB
のWindows環境でComfyUIから実際に動かしてみました。
単に5秒動画が生成できるかだけではなく、
- 5秒・10秒・15秒のImage-to-Video
- 映像と音声の同時生成
- Turbo 4step / 8step比較
- INT8 ConvRot / FP8比較
- Reference-to-Videoによるキャラクター維持
- VRAMとシステムRAMの実使用量
まで確認しています。
先に結論:
RTX 5070 Ti 16GBでは、MiniMax H3の5~15秒動画生成まで問題なく完走しました。
ただし、VRAMだけで動いているわけではありません。今回の構成では物理RAM使用量が最大約46GBまで上がっており、システムRAMもかなり重要です。
MiniMax H3とは?
MiniMax H3は、映像だけでなく音声も同時に生成できる動画生成モデルです。
ローカル版では主に次の2系統を使えます。
| 方式 | 用途 |
|---|---|
| I2V / FL2VA | 入力画像を起点として動画化する |
| R2V / Ref2VA | 画像・動画・音声などを参照し、新しい動画を生成する |
特にR2Vは、「この画像そのものを動かす」というより、参照した人物・服装・雰囲気などを保ちながら別のシーンを作る用途に向いています。
今回試した範囲では、I2VよりR2Vの方が「同じキャラクターを別の場所へ登場させる」という用途では面白く感じました。
今回の検証環境
今回使用したPC環境は次の通りです。
| CPU | Intel Core i5-12600K(10コア / 16スレッド) |
|---|---|
| GPU | NVIDIA GeForce RTX 5070 Ti |
| VRAM | 16,303MiB(16GB) |
| システムRAM | 48GB(Windows認識 47.8GB) |
| OS | Windows 11 Pro Build 26200 |
| NVIDIA Driver | 610.62 |
| ComfyUI | 0.37.0 |
| Python | 3.13.14 |
| PyTorch | 2.13.0+cu130 |
| モデル保存先 | F: SATA SSD |
今回重要なのはPyTorchがcu130環境である点です。
ComfyUI向けMiniMax H3では、cu130を利用できる場合はINT8 ConvRot版が推奨されているため、後半ではFP8版との実測比較も行いました。
使用したモデル
Image-to-Video
minimax_h3_fl2va_pruned_int8_convrot.safetensors
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
minimax_h3_video_vae_int8_convrot.safetensors
minimax_h3_audio_vae_fp32.safetensors
minimax_h3_fl2v_turbo_4step_v1.0_768p_comfyui_bf16.safetensors
4stepとの比較用として、次の8step版LoRAも使用しました。
minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensorsReference-to-Video
minimax_h3_ref2va_pruned_int8_convrot.safetensors
minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16.safetensors
Text EncoderとVideo VAE、Audio VAEはI2Vと共用できます。
まずは1枚の画像からImage-to-Video
今回の入力画像はこちらです。
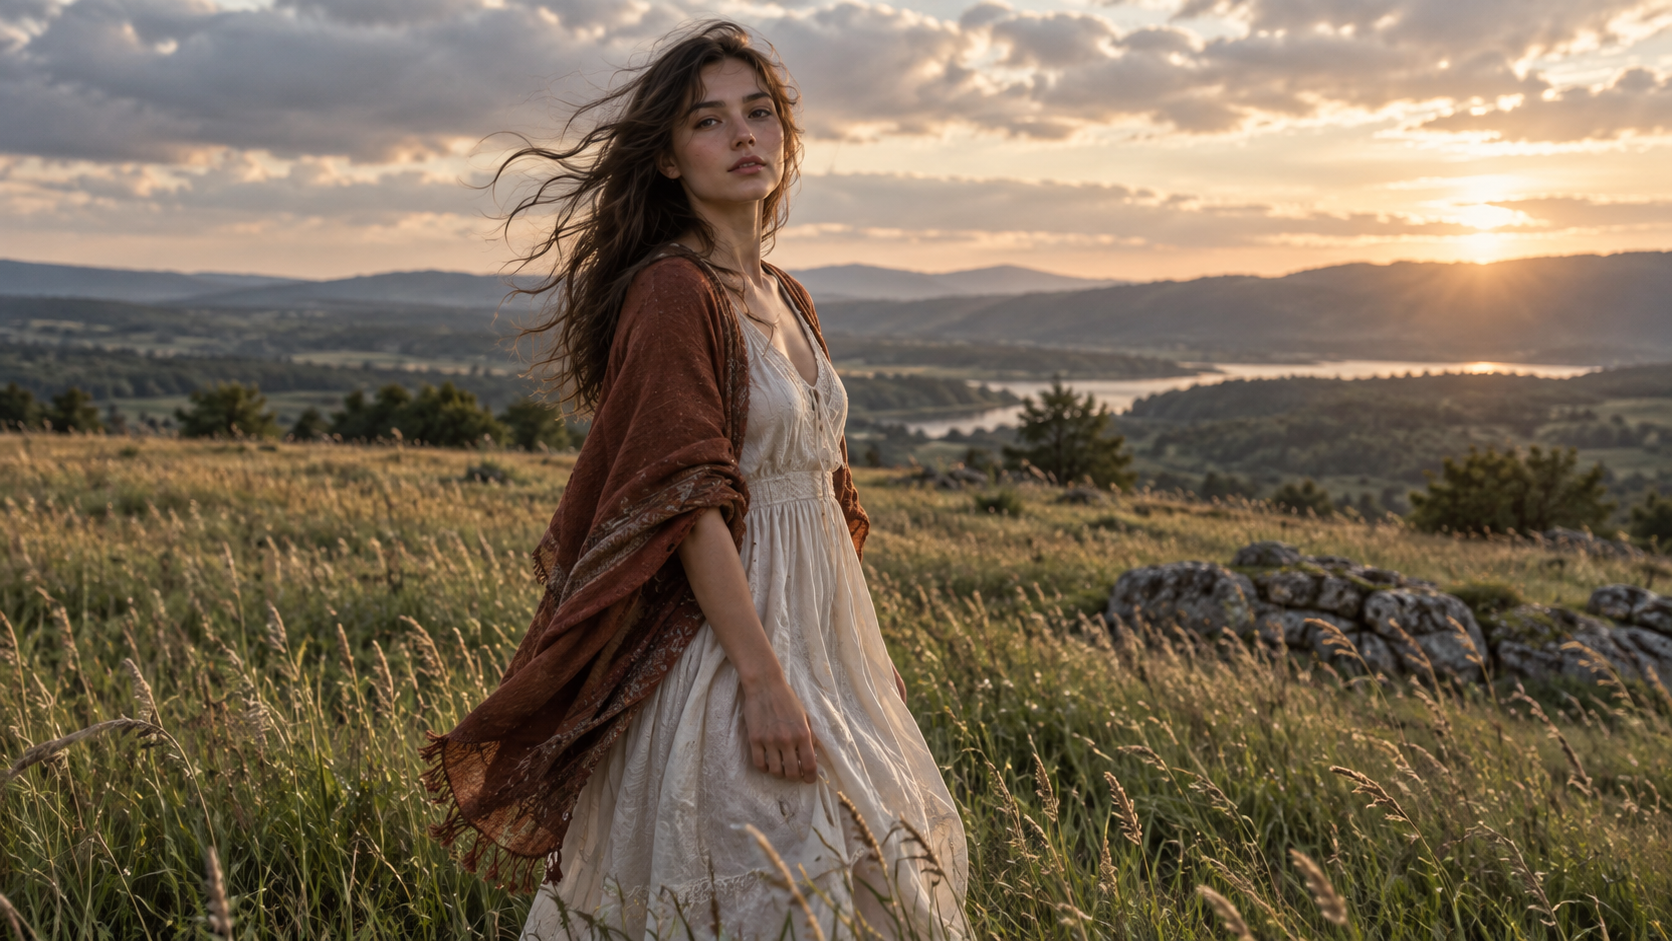
最初は、髪・服・草原が風で動き、カメラがゆっくり寄る程度の比較的シンプルなプロンプトから試しました。
5秒動画は問題なく生成され、人物は静止したままではなく実際に歩き出すような動作まで生成されました。
また、MiniMax H3は映像と同時に音声も生成します。
最初の動画では小さいながらも風のような環境音が確認できました。
5秒・1.0MPでも生成可能だった
解像度を1.0MPの1376×768まで上げた5秒版はこちらです。
生成時間は209.96秒(約3分30秒)でした。
なお、ComfyUI公式テンプレートでは16:9の768p相当として0.98MP・1344×768が案内されています。
1.0MPでは1376×768となるため、今回の1376×768は「推奨設定」ではなく、少し上まで実際に生成できるか確認したテストとして扱っています。
10秒動画では具体的な人物動作も確認
次に864×480・10秒へ伸ばし、プロンプトへ具体的な人物動作を追加しました。
特に分かりやすかったのが、
- 歩く
- 手で髪を払う
- その後カメラ側を見る
という指示です。
完全に指示通りのタイミングではありませんが、髪を払った後にこちらを見る動きは実際に確認できました。
一方、
- 突然強い風が吹く
- 草やショールを大きく揺らす
- 風の音を特に強調する
といった環境側の指示は、人物動作ほど明確には反映されませんでした。
風を強調するとショールの動き自体は大きくなるものの、「突風が来た」と一目で分かるほどの変化にはなりませんでした。
また音についても、プロンプトで風を強調しても大きな差が出ない場合があり、別の生成では足音が中心になったり、BGMのような柔らかい音が生成されたりしました。
今回の印象では、身体動作の指示は比較的拾いやすい一方、環境音や風などの演出は毎回狙い通りになるとは限らないようです。
15秒動画もRTX 5070 Ti 16GBで生成できた
さらに864×480のまま、動画長を15秒まで伸ばしました。
Turbo 4stepでの生成時間は、
245.97秒(約4分06秒)
でした。
15秒まで伸ばしても人物が途中で大きく崩れることはなく、動画として成立しています。
ただし、
静止 → 髪を払う → カメラを見る → 歩く → 最後に減速
のように時間順で細かく指示しても、実際には最初からほぼ同じ速度で歩き続けました。
個別のアクションは拾えていても、15秒のタイムラインへ文章だけで細かく動作を配置する精度はまだ完璧ではないと感じました。
Turbo 4stepと8stepを比較
MiniMax H3ではTurbo LoRAを使い、少ないstep数で高速生成できます。
今回は15秒・864×480で4stepと8stepをそれぞれ試しました。
| 設定 | Sampling | 総生成時間 |
|---|---|---|
| Turbo 4step | 約188.7秒 | 245.97秒 |
| Turbo 8step | 約374.2秒 | 409.75秒 |
Sampling時間はほぼ2倍になっています。
8step版はこちらです。
生成時間はかなり伸びましたが、今回の人物動画ではその時間差に見合うほど明確な品質向上は感じませんでした。
なお、この4step / 8step比較はSeedが異なるため厳密な同一条件A/Bテストではありません。
それでも実際に何度も生成を試す用途を考えると、今回の環境では4step Turboの方が使いやすいと感じました。
FP8とINT8 ConvRotを同条件で比較
今回もう一つ確認したのが、Diffusion Modelの量子化方式です。
最初は、
minimax_h3_fl2va_pruned_fp8_scaled.safetensorsを使っていました。
その後、同じ21GB級の、
minimax_h3_fl2va_pruned_int8_convrot.safetensorsへ変更しました。
比較では、モデルキャッシュを一度アンロードし、
- 同じ入力画像
- 同じSeed
- 同じプロンプト
- 864×480
- 10秒
- Turbo 4step
という条件を揃えています。
| INT8 ConvRot | FP8 Scaled | |
|---|---|---|
| Sampling | 87.56秒 | 102.76秒 |
| 総生成時間 | 182.05秒 | 191.44秒 |
| 物理RAMピーク | 46.1GB | 46.2GB |
| Commitピーク | 72.6GB | 74.2GB |
| VRAMピーク | 15.1GB | 15.1GB |
INT8 ConvRotは総生成時間で約5%、Sampling部分では約15%高速でした。
映像自体を見比べても、今回の条件ではほぼ同じ内容・品質に見えました。
MP4のファイルサイズには約100KB程度の差が出ましたが、これは動画圧縮時の動きや音声の違いでも変動するため、画質差として扱うほどではないと考えています。
今回の環境はPyTorch cu130なので、今後はINT8 ConvRot版を使用することにしました。
16GB VRAMなのに約20GBのモデルが動く
今回かなり印象的だったのが、メモリ管理です。
ComfyUIのログでは、
MiniMaxH3TEModel_ prepared for dynamic VRAM loading.
14956MB Staged.

MiniMaxH3 prepared for dynamic VRAM loading.
19995MB Staged.
と表示されています。
Text Encoderだけで約15GB、Diffusion Modelは約20GB規模です。
RTX 5070 TiのVRAMは16GBなので、当然すべてを同時にVRAMへ常駐させることはできません。
しかし実際の生成では、
| 最大VRAM使用量 | 約15.1GB |
|---|---|
| 最大物理RAM使用量 | 約46.2GB |
| 最大Committed Memory | 約74GB |
となり、ComfyUIのDynamic VRAM LoadingとCPU Offloadを利用しながら生成が完了しました。
以前のローカル生成では「モデルサイズがVRAMより大きい=実用が難しい」というケースが多くありました。
現在は、
- INT8 / FP8 / NVFP4などの量子化
- 混合精度演算
- Dynamic VRAM Loading
- CPU Offload
- 必要な重みだけをGPUへ載せる仕組み
などの進歩によって、VRAM容量を超えるモデルでも現実的に動かせるケースが増えています。
MiniMax H3は、その進歩をかなり実感できるモデルでした。
ではRAM 32GBでも動く?
今回の48GB環境では、物理RAM使用量が最大約46GBまで上がりました。
これだけを見ると32GBでは難しそうですが、MiniMax H3には低メモリ環境向けの量子化モデルや最適化ワークフローも存在します。
コミュニティでは8GB VRAM・16GB RAMなど、今回よりかなり少ないメモリで生成している例もあります。
ただし、
- より小さいText Encoderへ変更する
- 低VRAM向けモデルを使う
- 低解像度にする
- RAM CleanupやOffloadを増やす
- SSDのページファイルへ依存する
など、今回とは条件が大きく異なります。
低メモリ環境では「動くかどうか」よりも、1本生成するのに何分待つことになるかの方が重要だと思います。
動画生成は一発で理想の結果になるとは限りません。
10~20分待った動画が外れだった場合、もう一度同じ時間をかけて試す必要があります。
そのため、
生成できることと、実用的に使えることは別
と考えた方がよさそうです。
今回のRTX 5070 Ti 16GB+RAM 48GBでは、10秒動画でも数分程度で試行できたため、何度かSeedやプロンプトを変えて試す使い方も十分現実的でした。
Reference-to-Videoも試す
MiniMax H3で個人的に特に面白かったのがReference-to-Video(R2V)です。
I2Vが、
「この画像を動かす」
機能なのに対し、R2Vは、
「この画像の人物や特徴を参照して、新しい動画を作る」
という使い方ができます。
今回は先ほどの草原の女性画像を1枚だけ参照し、
「同じ女性が夜の街を歩く」
よう指示しました。
結果はかなり分かりやすく、
- 長い茶色の髪
- 白いドレス
- 茶色系のショール
- 人物全体の雰囲気
を維持しながら、草原から夜の街へシーンそのものを変更できました。
864×480・5秒・Turbo 4stepで、生成時間は133.12秒でした。
単純な一枚絵の動画化だけならI2Vで十分ですが、同じキャラクターを別の場所や状況へ登場させたい場合は、R2Vの方がかなり応用範囲が広そうです。
I2VとR2Vの使い分け
| やりたいこと | おすすめ |
|---|---|
| 今ある画像をそのまま動かしたい | I2V |
| 元画像の構図を維持したい | I2V |
| 同じ人物を別の場所へ移したい | R2V |
| キャラクターの一貫性を重視したい | R2V |
| 複数画像・動画・音声を参照したい | R2V |
かなり単純化すると、
I2V=画像を動かす
R2V=参照素材を使って新しい動画を作る
という理解が分かりやすいと思います。
今回の生成時間まとめ
| テスト | 解像度 | 長さ | 設定 | 生成時間 |
|---|---|---|---|---|
| I2V軽量テスト | 736×416 | 約5秒 | 4step | 126.91秒 |
| I2V 1.0MPテスト | 1376×768 | 約5秒 | 4step | 209.96秒 |
| I2V 10秒 | 864×480 | 約10秒 | 4step | 約143~158秒 |
| I2V 15秒 | 864×480 | 約15秒 | 4step | 245.97秒 |
| I2V 15秒 | 864×480 | 約15秒 | 8step | 409.75秒 |
| R2V | 864×480 | 約5秒 | 4step | 133.12秒 |
※INT8 / FP8の厳密比較は、モデルをアンロードしてから再ロードしたため、上記の連続生成時とは総処理時間の条件が少し異なります。
以前試したWan2.2 5Bと比べると
以前、ComfyUIでWan2.2 5Bを使ったImage-to-Videoも試しました。
Wan2.2 5Bは比較的軽量で、ローカル動画生成を初めて試す用途では扱いやすいモデルです。
一方MiniMax H3はかなり大型ですが、
- 最大15秒クラスの動画生成
- 映像と音声の同時生成
- Reference-to-Video
- キャラクター参照
- 画像・動画・音声を使った高度な参照
など、できることが大きく広がっています。
その代わり、VRAMだけでなくシステムRAMやモデルロードの仕組みまで含めたPC全体の性能が重要になっています。
MiniMax H3のライセンスについて
MiniMax H3はオープンウェイトですが、独自のMiniMax H3 Community License Agreementで提供されています。
地域制限や商用利用時の条件、年間売上に応じた追加条件なども定められているため、仕事・商用サービス・製品への組み込みなどを考えている場合は、必ず利用時点の公式ライセンスを確認してください。
まとめ:16GB VRAMでも大型動画モデルがかなり現実的になってきた
今回MiniMax H3を試して一番印象に残ったのは、動画そのものの品質だけではありません。
約20GB級のDiffusion Modelを、VRAM 16GBのRTX 5070 Tiで普通に動かせたことです。
もちろん実際にはRAMを最大約46GB使用しており、16GBのVRAMだけで処理しているわけではありません。
それでも、以前なら「モデルがVRAMに収まらない時点で厳しい」と判断していたような規模のモデルを、現在は量子化・Dynamic VRAM・CPU Offloadなどによって数分単位で生成できています。
今回の環境では、
- 5秒 → 約2~3分台
- 10秒 → 約2分半前後
- 15秒 → 約4分
程度で試せました。
動画生成はSeedによる当たり外れも大きいため、この「何度も試せる速度」はかなり重要です。
また、R2Vで元画像の人物を維持したまま夜の街へ移せたのも面白く、単純なI2Vより今後使ってみたい機能だと感じました。
RTX 5070 Ti 16GBクラスのGPUと十分なシステムRAMがあれば、MiniMax H3は「一応動く」ではなく、実際に何度も試しながら使えるローカル動画生成モデルになってきていると思います。
コメント