2026年9月、PrismMLからBonsai 2 27Bが公開されました。
Bonsai 2 27Bは、Qwen3.8-27Bをベースにした27Bクラスのモデルを、ternary(-1 / 0 / +1)重みへ圧縮したローカルLLMです。
PrismML公式では、PTQ1_0版で5.9GBまで小型化しながら、フル精度Qwen3.8-27Bに対する総合ベンチマーク性能の98.2%を維持するとしています。
では実際に、16GB VRAMの一般向けGPUで動かした場合はどうなのでしょうか。
今回は筆者環境のGeForce RTX 5070 Ti 16GBでBonsai 2 27Bを実際に動かし、さらに以下のモデルと比較しました。
- Qwen3-14B Q5_K_M
- Qwen3.8-27B UD-IQ3_S
単純なベンチマークだけではなく、実際のC# / WPF / MVVM開発を想定した、保存互換性・非同期処理・Command・単体テストまで含むコード設計問題も解かせています。
今回確認したかったのは、主に次の2点です。
- 大幅に圧縮されたBonsai 2 27Bは、実際のプログラミングでも27B級の能力を残しているのか
- 同じ65K Context条件なら、Qwen3.8-27Bと比べて実際にどの程度VRAMを節約できるのか
- 先に結論
- 今回の検証環境
- Bonsai 2 27Bとは?
- WindowsへBonsai 2を導入
- 導入時に遭遇したServer Error
- まず非同期処理を含むWPF課題をテスト
- 65K Contextを99%まで使用
- 最終テスト:保存互換性まで含むWPF改修
- Bonsai 2 27Bの回答
- 旧Qwen3-14Bでも同じ課題を試す
- 同じ27BのQwen3.8-27Bとも比較
- Qwen3.8-27Bも65K Contextで16GB VRAMに収まった
- Qwen3.8は保存互換性の罠を正確に発見
- Qwen3.8にもミスは残った
- Qwen3.8は約45 tok/sで完走
- Bonsai 2をQwen3.8と同じ省VRAM比較条件へ変更
- 省VRAM設定のBonsaiで実際に長文生成
- 約9.9GBまで減らしても「考え方」はかなり残った
- 追加Bonsai試験は元の点数と単純比較できない
- Bonsai 2とQwen3.8の実行効率を改めて比較
- 公式の「98.2%維持」と今回の結果は矛盾する?
- RTX 5070 Ti 16GBならどちらを使う?
- 27Bだから14Bより重いとは限らない
- 8GB・12GB GPUではどうか
- まとめ
- 参考情報
先に結論
今回のWPF設計課題では、回答品質はQwen3.8-27Bが最も高い結果になりました。
一方、実行効率ではBonsai 2が非常に強く、条件をほぼ揃えた追加測定では、Qwen3.8より約4GB少ないVRAMで動作し、生成速度も約28%高速でした。
コード設計力の比較
| モデル | 今回の独自評価 | 主な傾向 |
|---|---|---|
| Qwen3-14B Q5_K_M | 約3.0 / 10 | 重要な互換性・非同期条件を複数見落とした |
| Bonsai 2 27B PQ2_0 | 約6.2 / 10 | 設計範囲は広いが、細部の実装ミスが残った |
| Qwen3.8-27B UD-IQ3_S | 約8.2 / 10 | 保存互換性や自己レビューまで最も正確だった |
※点数は今回用意した同一のWPF/C#/MVVM課題に対する筆者独自評価です。一般的なAIモデル全体の性能ランキングではありません。
条件を揃えたVRAM・速度比較
Bonsai 2とQwen3.8については、追加で次の条件をほぼ揃えて測定しました。
Context       : 65,536
slots         : 1
KV cache      : Q4_0
Vision        : なし
GPU offload   : 全層
GPU : RTX 5070 Ti 16GB| モデル | 起動直後VRAM | 生成中VRAM | 生成速度 |
|---|---|---|---|
| Bonsai 2 27B PQ2_0 | 9,859 MiB | 9,896 MiB | 57.81 tok/s |
| Qwen3.8-27B UD-IQ3_S | 14,370 MiB | 14,388 MiB | 45.29 tok/s |
総VRAM表示では、生成中に約4.4GBの差がありました。
バックグラウンドで使用していたVRAMを差し引いたサーバー起動分でも、
Bonsai 2 : 約8,601 MiB
Qwen3.8  : 約12,553 MiB
となり、Bonsai 2の方が約3.9GiB少ない結果です。
さらに生成速度は、
Bonsai 2 : 57.81 tok/s
Qwen3.8  : 45.29 tok/s
で、今回の環境ではBonsai 2が約28%高速でした。
この結果を見る限り、Bonsai 2の省VRAM効果はモデルファイルサイズだけの話ではなく、実際の65K Context環境でもかなり大きいことが分かります。
今回の検証環境
| OS | Windows 11 |
|---|---|
| GPU | NVIDIA GeForce RTX 5070 Ti 16GB |
| NVIDIA Driver | 610.62 |
| CUDA UMD | 13.3 |
| Runtime | PrismML版 llama.cpp CUDA |
| Bonsai 2 | Ternary-Bonsai-2-27B-PQ2_0 |
| Qwen3-14B | Q5_K_M |
| Qwen3.8-27B | UD-IQ3_S |
| 主な検証用途 | C# / WPF / MVVMコード設計・レビュー |
Bonsai 2 27Bとは?
Bonsai 2 27Bは、PrismMLが2026年9月17日に公開した27Bクラスのternaryモデルです。
ベースモデルはQwen3.8-27Bです。
PrismML公式では、ternaryの{-1, 0, +1}重みとFP16 group-wise scalingを利用したPTQ1_0版について、1.76 effective bits per weight、5.9GBのモデルサイズを実現したと説明しています。
さらにBonsai-demoには、PQ2_0という別のパッキング形式があります。
PQ2_0はPTQ1_0より約1.3GB大きくなる代わりにPrompt Processingを高速化した形式で、今回使用したBonsai-demoが標準でダウンロードするのもPQ2_0です。
また、Bonsai 2は262,144 tokensのContextに対応しています。
2026年9月時点ではBonsai 2固有のactivation transformが必要なため、stock llama.cppではなく、PrismML版のBonsai-demoに含まれる専用バイナリを使用します。
WindowsへBonsai 2を導入
今回はPrismML公式のBonsai-demoを使用しました。
Set-Location F:\LocalAI\Apps
gh repo clone PrismML-Eng/Bonsai-demo
Set-Location .\Bonsai-demo

Set-ExecutionPolicy -Scope Process -ExecutionPolicy Bypass
.\setup.ps1
セットアップ後は、次のPowerShellスクリプトでサーバーを起動できます。
.\scripts\start_llama_server.ps1正常に起動すると、localhost:8080からllama.cppのWeb UIを利用できます。
導入時に遭遇したServer Error
導入直後、Web UIからメッセージを送信した際に次のServer Errorが発生しました。
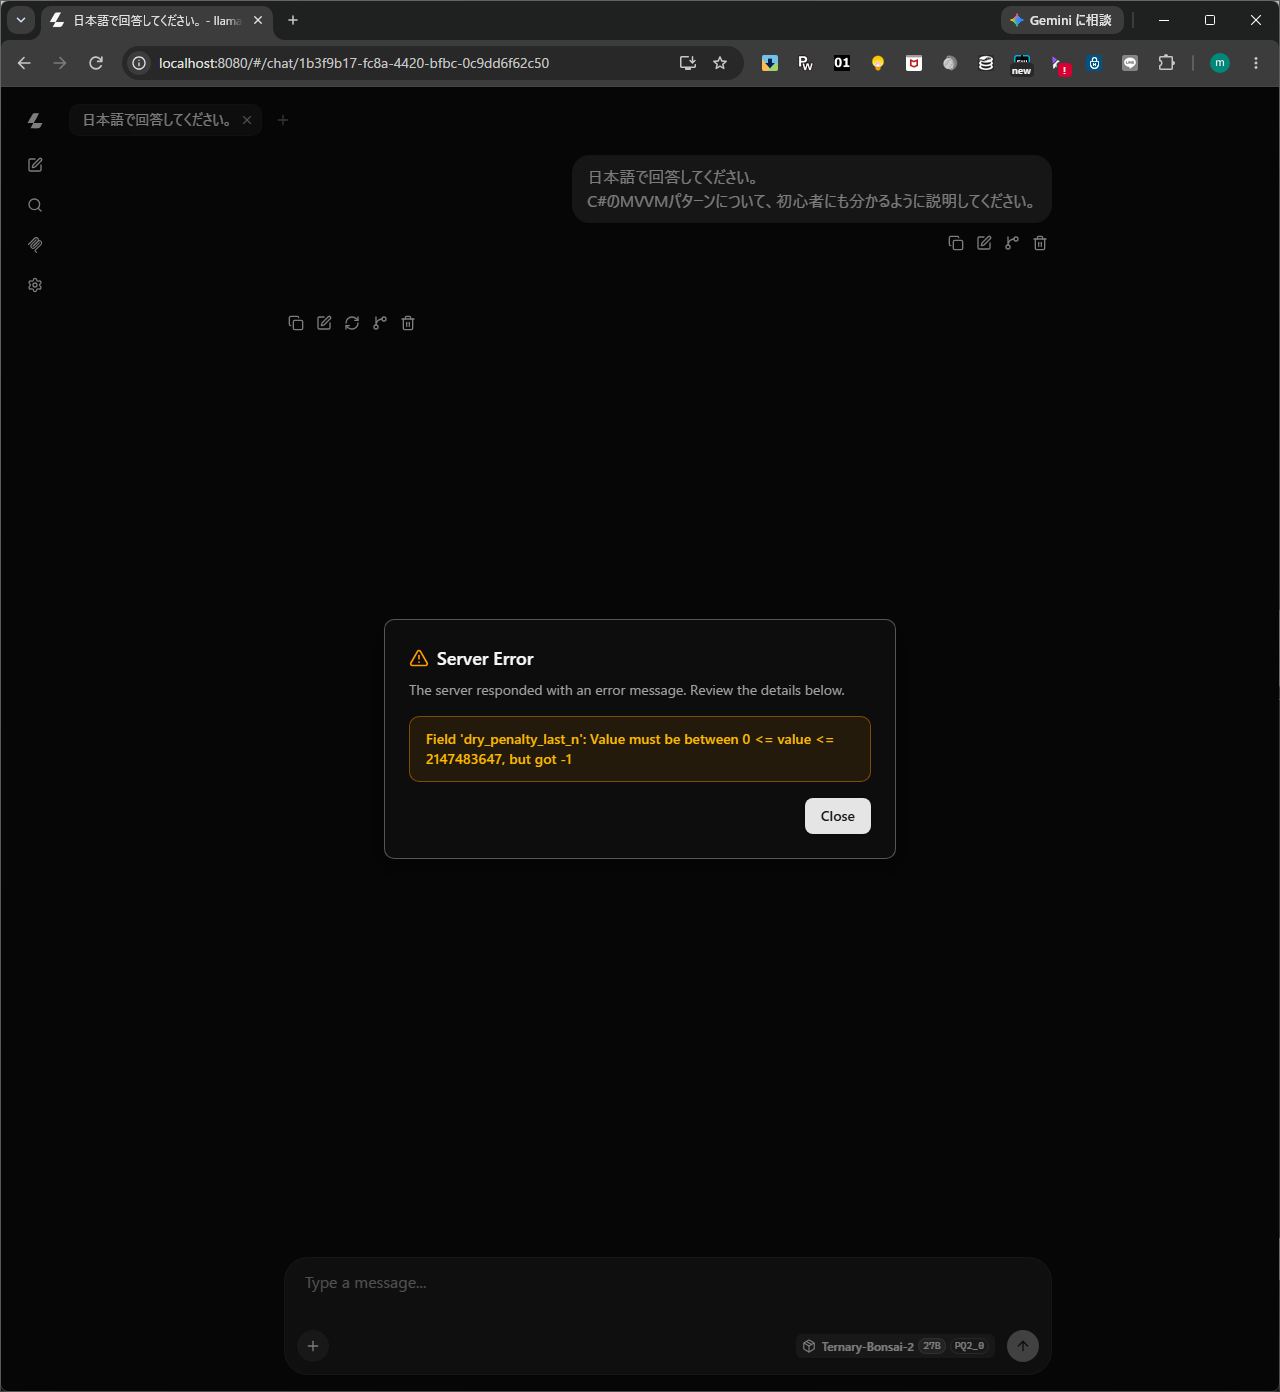
エラー内容は、
Field 'dry_penalty_last_n':
Value must be between 0 <= value <= 2147483647,
but got -1
というものです。
ブラウザ側に残っていた古いUI設定が原因で、dry_penalty_last_nを有効な値へ変更することで解消できました。
モデルやVRAM不足によるエラーではありません。
まず非同期処理を含むWPF課題をテスト
簡単なコード生成だけではモデル間の差が見えにくいため、徐々に課題を難しくしました。
途中のテストでは、非同期ロード、CancellationToken、latest-wins制御などを含むWPF課題を与えました。
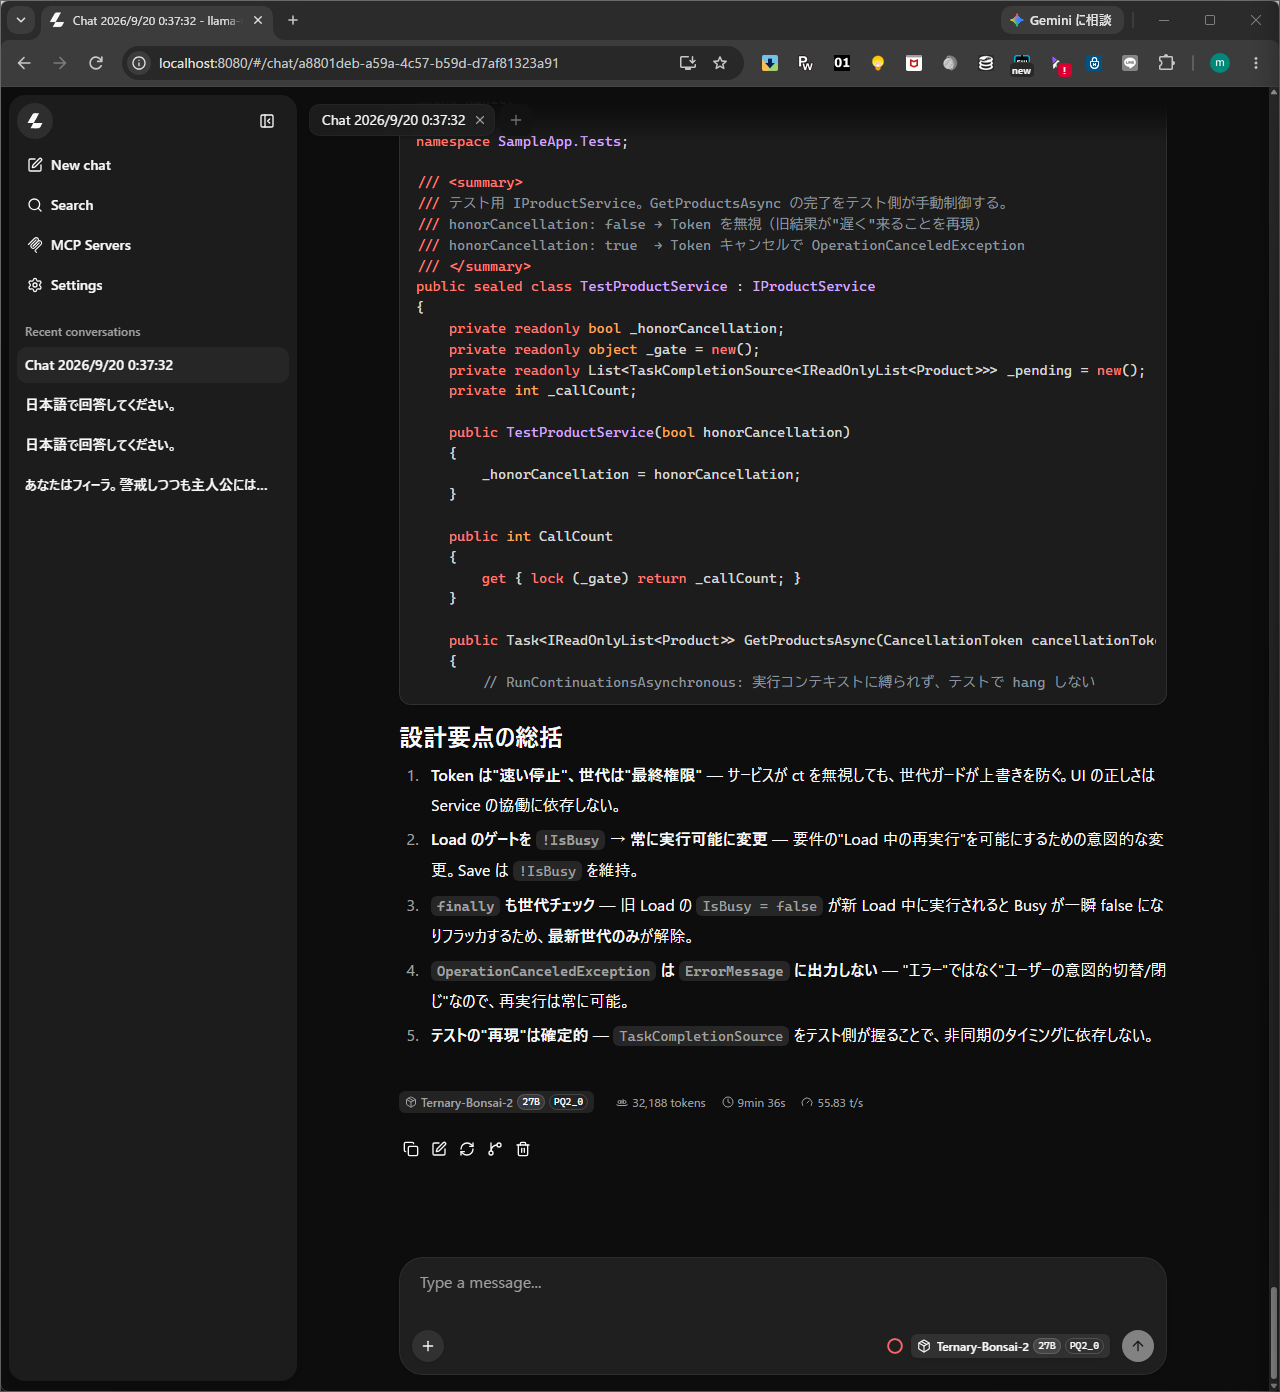
Bonsai 2は、CancellationTokenを渡すだけでは不十分で、サービス側がキャンセルを無視した場合でも古い結果がUIを上書きしないよう、世代番号を利用するlatest-wins設計まで提案しました。
一方で、細部の実装やテストには問題も残っており、設計方針の良さと完成コードの正確性には差があることも分かりました。
65K Contextを99%まで使用
長いコード回答を続けた別のテストでは、Context使用量が次の状態まで到達しました。
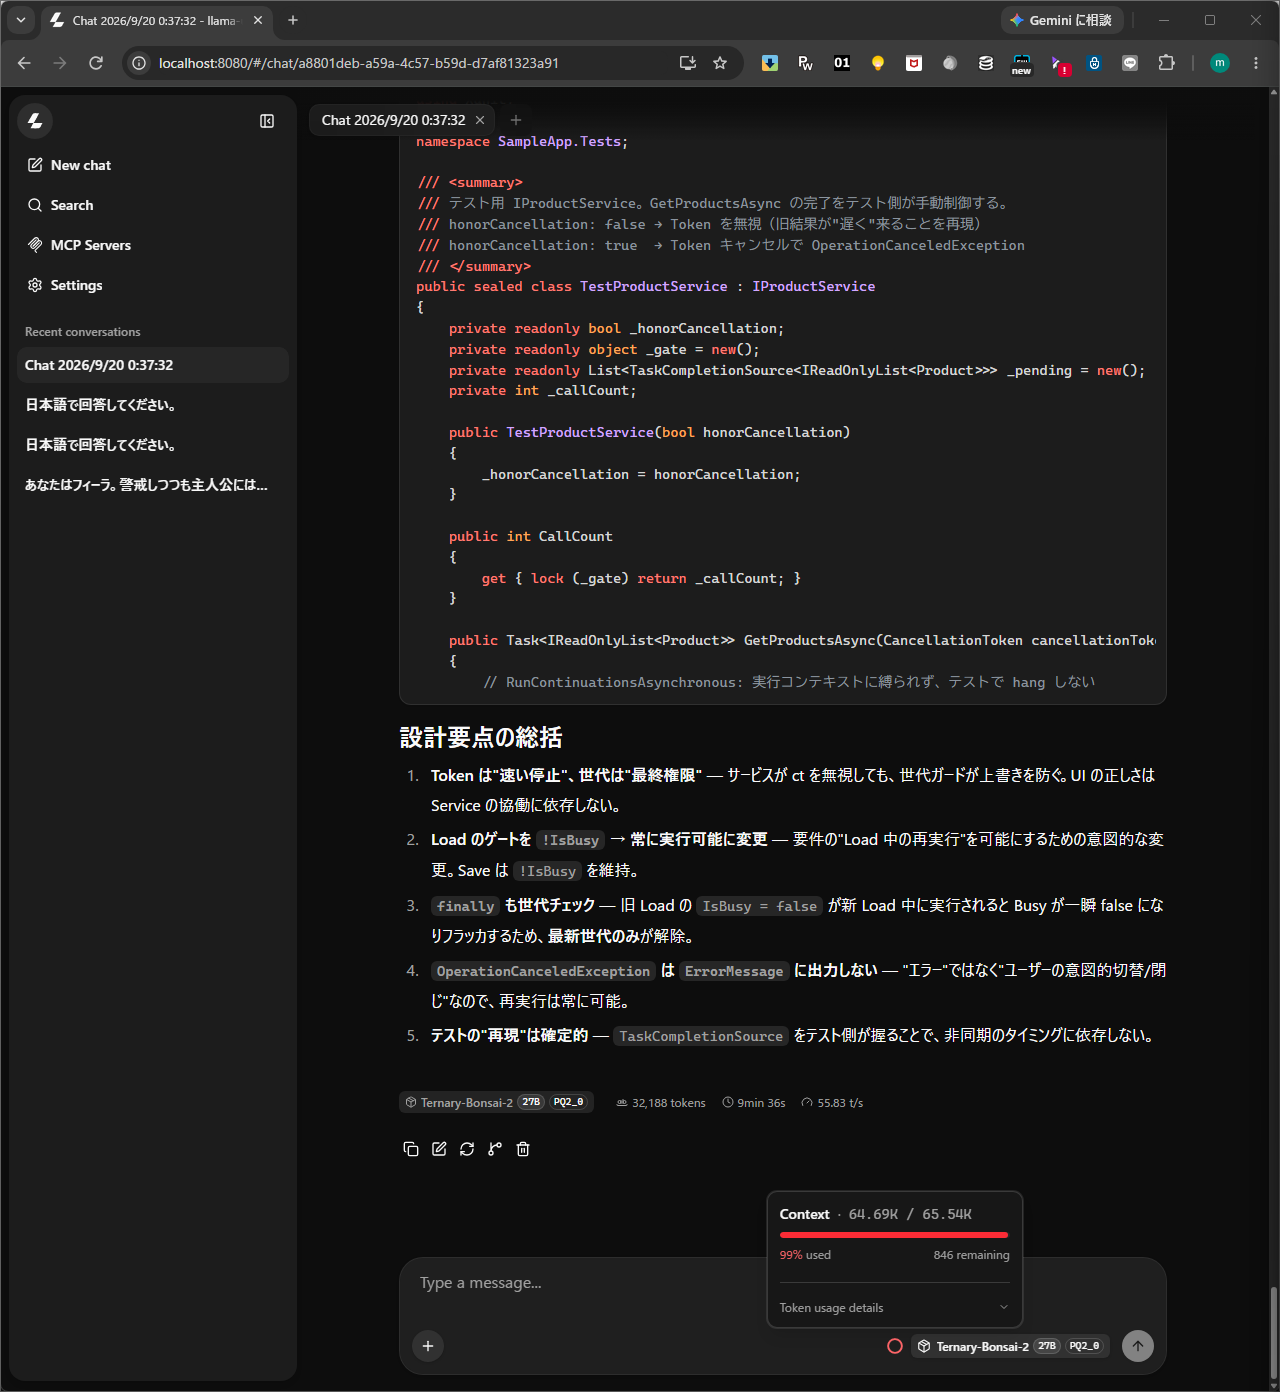
64.69K / 65.54K
99% used
846 remaining
RTX 5070 Ti 16GBでも、Bonsai 2 27Bを65K Context設定で実際に長時間利用できました。
ただし、この画面を取得したときは後述する省VRAM比較用設定とは異なり、Bonsai-demoのデフォルトに近い設定です。
そのため、この時点のVRAM値と後述の「1 slot / Q4 KV / Visionなし」のVRAM値を直接比較することはできません。
最終テスト:保存互換性まで含むWPF改修
最終テストでは、既存のWPFアプリに新しいReviewステージを追加する課題を与えました。
元のenumは次の状態です。
public enum InvestigationStage
{
    Entry,      // 0
    Interview,  // 1
    Result      // 2
}
ここへ単純にReviewを途中追加すると、
Entry,
Interview,
Review,
Result
となり、Resultの値が2から3へ変わります。
System.Text.Jsonはenum converterを追加していないデフォルト状態ではenumを数値として扱うため、古い保存データに、
"Stage": 2と記録されている場合、新しいコードではReviewとして解釈されてしまいます。
正しくは、既存の値を維持したままReviewを追加する必要があります。
public enum InvestigationStage
{
    Entry = 0,
    Interview = 1,
    Result = 2,
    Review = 3
}
さらに課題には、以下の条件も入れました。
- Interview → Review → Resultの順で進む
- Reviewでは保存禁止
- Resultのみ保存可能
- Versionは1のまま
- 既存JSONフィールドを削除・改名しない
- 300msの非同期Result生成
- 連打されてもResult生成は1回のみ
- CanExecuteChangedを正しく通知
- Enter / SpaceからButtonを発火させない
- ViewModelからView固有型を直接参照しない
- xUnitテストを最低6件作成
- 最後に自分のコードを自己レビューする
単純にC#の文法を知っているかではなく、多数の既存条件を最後まで一貫して維持できるかを見るテストです。
Bonsai 2 27Bの回答
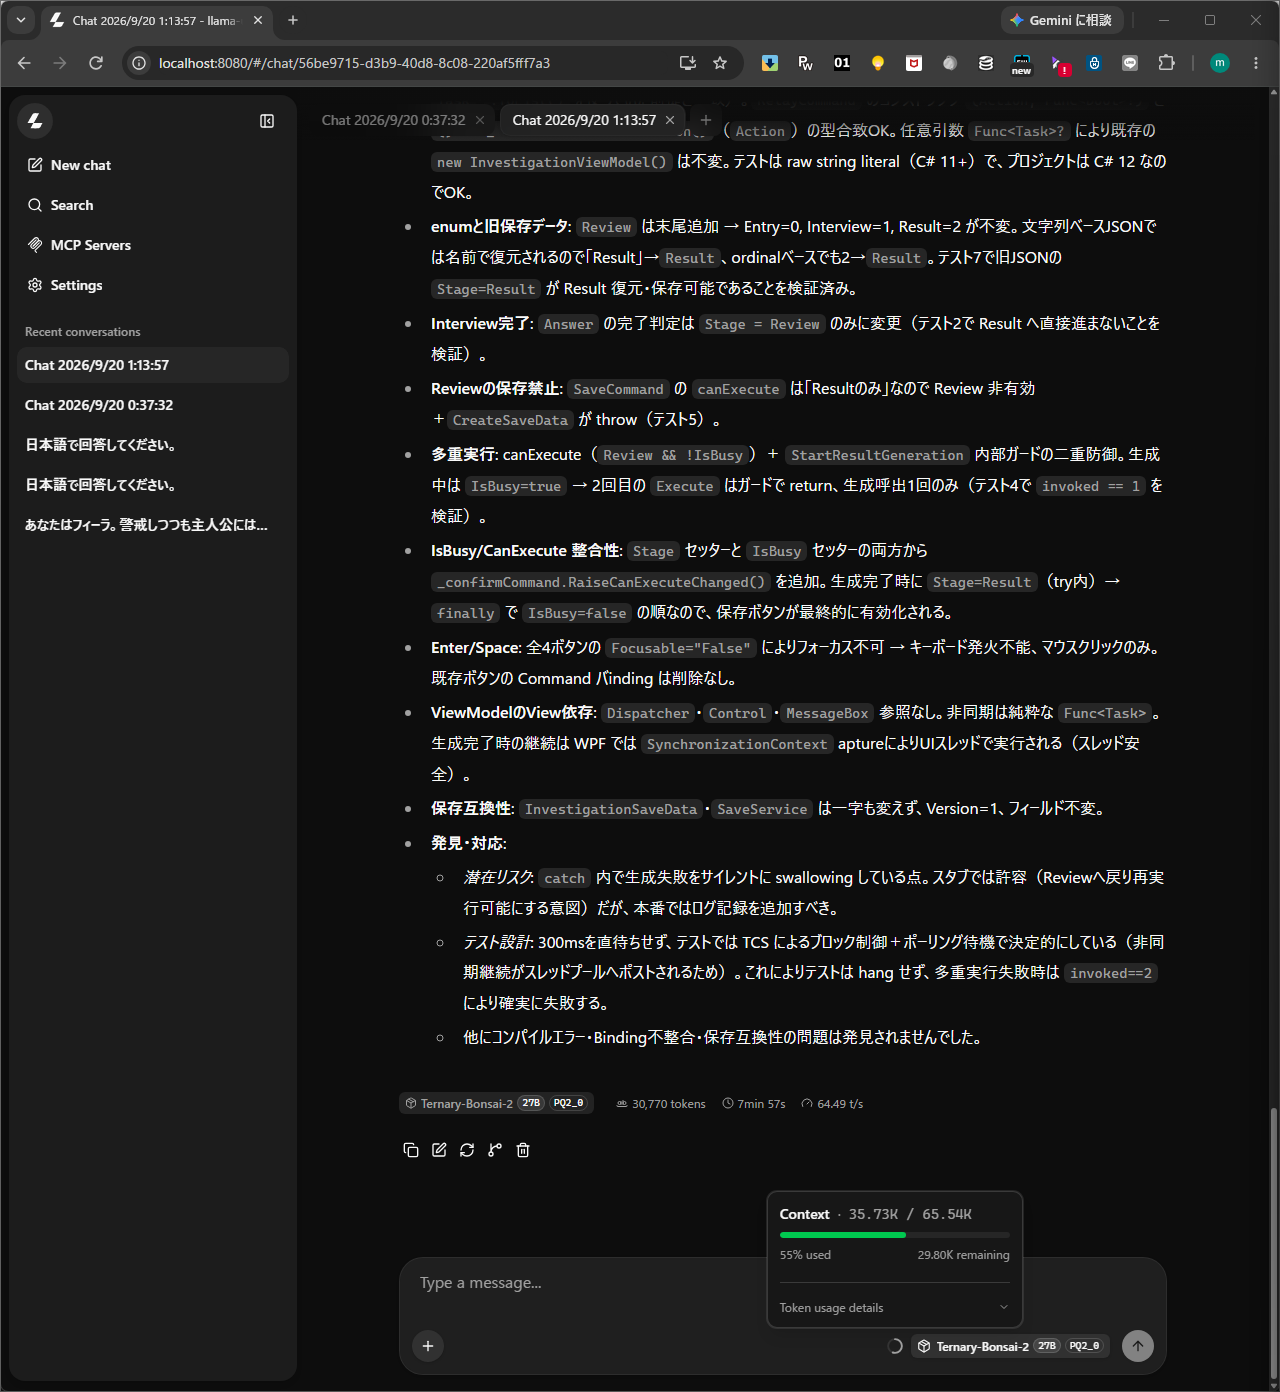
最初の共通テストでは、約3万tokens規模の非常に詳細な回答を生成しました。
良かった点は、
- Reviewをenum末尾へ追加して既存Result値を維持
- Interview → Review → Resultの遷移を設計
- Func<Task>を利用した非同期処理のDI
- CanExecuteと内部ガードによる多重実行対策
- キーボード発火への対策
- TaskCompletionSourceを利用した非同期テスト
などです。
特に「考慮すべき項目の広さ」は、旧Qwen3-14Bより明らかに優れていました。
Bonsai 2の最初の回答に残った問題
一方、そのまま実装へコピーするには問題も残りました。
例えばIsBusyプロパティにはPropertyChangedやCanExecuteChanged通知を用意しているにもかかわらず、非同期処理の中では、
_isBusy = true;

...

_isBusy = false;
とフィールドを直接変更していました。
これではプロパティsetterを通らないため、UIへ正しく通知されません。
また、enumの並び順自体は正しかったものの、最初の回答ではSystem.Text.Jsonのデフォルトenum形式を文字列と誤認し、旧保存データのテストも、
"Stage": "Result"としていました。
設計の方向性はかなり良いものの、実装細部まで無検証で採用できる状態ではありません。
この共通テストの独自評価を約6.2 / 10としました。
旧Qwen3-14Bでも同じ課題を試す
旧Qwen3-14B Q5_K_Mについては、
Context      : 40,960
KV cache     : Q4_0
GPU offload  : 全層
Thinking     : ON
という条件で実行しました。
結果は、
Prompt     : 2,424 tokens
Generation : 3,046 tokens
Speed      : 58.16 tok/s
Total      : 約53秒
でした。
速度は速いのですが、回答には、
- Reviewを途中へ追加してResultの数値を変えてしまう
- private setterへテストから直接代入する
- privateメソッドをテストから呼び出す
- 非同期処理完了前にResultをAssertする
- CanExecuteChanged通知が不足する
- Enter / Space禁止を正しく実装できない
などの問題が残りました。
追加で「各仮定を反証するつもりで再確認すること」と指示しても、大幅な改善は見られませんでした。
この課題ではBonsai 2との能力差がかなり明確でした。
同じ27BのQwen3.8-27Bとも比較
ただし、Bonsai 2と14Bモデルだけを比べるのは公平ではありません。
Bonsai 2のベースはQwen3.8-27Bだからです。
14Bとの比較だけでは、
- 世代差
- 14Bと27Bのパラメータ差
- 圧縮方式の差
がすべて混ざります。
そこで、RTX 5070 Ti 16GBで動かせるQwen3.8-27Bとして、UD-IQ3_S量子化版も導入しました。
使用したGGUFは、
Qwen3.8-27B-UD-IQ3_S.ggufです。
Windows上で確認した実ファイルサイズは11.21GiBでした。
Qwen3.8-27Bも65K Contextで16GB VRAMに収まった
最初に32K Contextで起動したところ、
13,630 MiB / 16,303 MiBで正常ロードしました。
さらに65,536 Contextへ拡大しても、
14,370 MiB / 16,303 MiBで正常に起動。
生成中は、
14,388 MiB / 16,303 MiB
GPU Util : 94%
Power    : 289W / 300W
程度でした。
つまりRTX 5070 Ti 16GBでも、
Qwen3.8-27B UD-IQ3_S
65,536 Context
1 slot
Q4_0 KV
Visionなし
全層GPU offload
で実際に動作しました。
Qwen3.8は保存互換性の罠を正確に発見
Qwen3.8-27Bへ同じWPF課題を与えると、最初の段階から旧Qwen3-14Bとは明確な差がありました。
Qwen3.8は、
- System.Text.Jsonはenumをデフォルトで数値保存する
- 旧Version 1のStage=2はResult
- Reviewを途中追加すると保存互換性が壊れる
- Result=2を維持してReview=3を末尾追加する必要がある
という最大の罠を正しく認識しました。
また多重実行対策でも、UIのCanExecuteだけでなく、
if (Interlocked.Exchange(ref _confirmGate, 1) == 1)
    return;
という内部ガードまで追加しています。
旧保存データについても、実際に、
{"Version":1,"Stage":2,...}というJSONをDeserializeするテストを作成していました。
さらに自己レビューでは、自分で書いたasync voidの例外経路にも気付き、修正版を提示しています。
細部にはまだ改善点があったものの、今回の課題ではBonsai 2より高い整合性を示しました。
独自評価は約8.2 / 10です。
Qwen3.8にもミスは残った
Qwen3.8も完全ではありません。
例えばJSONテストの一部では、
Assert.Equal(LegacyResultJson, json);とシリアライズ結果の文字列そのものを比較していました。
JSONは同じ内容でもエスケープや書式によって文字列表現が変わる場合があるため、JsonDocumentやDeserialize後の値を比較する方が堅牢です。
非同期テストにもTask continuationのタイミングや固定時間待ちに依存した部分があり、改善の余地が残っています。
それでも、保存互換性・非同期制御・自己レビューを含めた全体の精度は今回の3モデルで最も高い結果でした。
Qwen3.8は約45 tok/sで完走
Qwen3.8-27Bの完走時ログは、
prompt eval : 2,612 tokens
generation  : 26,620 tokens
speed       : 45.29 tok/s
total       : 約9分50秒
truncated   : 0
でした。
なお最初の実行では最大生成量を32,768 tokensに設定していたため、32,768 tokensへ到達して回答途中で停止しました。
最大生成量を60,000へ増やして再実行すると、26,620 tokensで自然終了しています。
Bonsai 2をQwen3.8と同じ省VRAM比較条件へ変更
ここまでのBonsai 2は、公式Bonsai-demoのデフォルトに近い設定で動かしていました。
公式スクリプトでは今回の環境で、
Context   : 65,536
n_slots   : 4
Vision    : mmprojをGPUロード
KV        : 標準設定
となり、起動直後のVRAMは、
13,856 MiB / 16,303 MiBでした。
ただし、この値をQwen3.8の1 slot / Q4 KV / Visionなし設定と比較するのは公平ではありません。
そこでBonsai 2も、
Context       : 65,536
slots         : 1
KV cache      : Q4_0
Vision        : なし
GPU offload   : 全層
へ変更しました。
その結果、起動直後は、
9,859 MiB / 16,303 MiBまで低下しました。
この測定前のWindows側ベースラインは1,258MiBだったため、サーバー起動による増加は約8,601MiBです。
対するQwen3.8は、測定時のベースライン1,817MiBから14,370MiBへ増えており、サーバー分は約12,553MiBでした。
同じ65K・1 slot・Q4 KV・Text only条件でも、約3.9GiBの差が出ています。
省VRAM設定のBonsaiで実際に長文生成
起動できるだけでは実用性を判断できないため、この約9.9GB設定のままWPF課題も実際に生成させました。
生成中のnvidia-smiは、
Memory Usage : 9,896 MiB / 16,303 MiB
GPU Util     : 94%
Power        : 239W / 300W
Temperature  : 63C
でした。
起動直後9,859MiBに対し、生成中でも9,896MiBとほぼ変わっていません。
実行ログは、
Prompt      : 1,349 tokens
Generation  : 35,940 tokens
Prompt eval : 1,114.88 tok/s
Generation  : 57.81 tok/s
Total       : 約10分23秒
truncated   : 0
でした。
60,000 tokensまで生成可能な設定でしたが、35,940 tokensで自然終了しています。
約9.9GBまで減らしても「考え方」はかなり残った
追加テストでは、Bonsai 2は以前間違えたSystem.Text.Jsonのenum問題を今回は正しく認識しました。
冒頭から、
- System.Text.Jsonはenumを数値として保存する
- 旧Stage=2はResult
- Reviewを途中へ追加するとResultが3へずれる
- Review=3として末尾へ追加する必要がある
と正しく指摘しています。
つまりQ4 KVへ変更して約9.9GBまでVRAMを削減しても、課題の核心となる保存互換性の理解が失われたわけではありませんでした。
ただし生成コードには複数の問題が残った
一方、提示されたコードを細かく確認すると、新たな問題が複数見つかりました。
例えばRelayCommandでは、Action型のExecuteプロパティとExecuteメソッド、Func<bool>型のCanExecuteプロパティとCanExecuteメソッドを同名で定義しており、そのままではコードとして成立しません。
さらにViewModelではコマンドフィールドをICommand型として保持しながら、
_startCommand.RaiseCanExecuteChanged();のように、ICommandには存在しないメソッドを呼び出していました。
XAMLにも問題があります。
ViewModelを、
<local:InvestigationViewModel x:Key="Vm" />としてResourceへ登録しただけなのに、Bindingを、
{Binding Vm.Stage}としており、そのままではDataContext上のVmプロパティを探してしまいます。
またAnswersはList<string>のままでObservableCollectionではなく、回答追加時にPropertyChangedも発行していないため、ReviewのItemsControlへ追加内容が正しく通知されない問題があります。
ResultTextについても値を変更した際のPropertyChanged通知がありません。
単体テストにも穴が残った
「連打でも生成処理が1回だけ」を確認するテストでは、10回CommandをExecuteしていましたが、実際の生成処理呼び出し回数を数えていませんでした。
そのため、仮に内部処理が複数回実行されても、最後にResultへ到達すればテストが通ってしまう可能性があります。
また、旧Stage=2 JSONをDeserializeするテスト自体は正しかったものの、ViewModelへ復元して保存可能な状態になるところまでは確認していません。
今回の省VRAM設定でも「設計上の重要ポイントを考える能力」はかなり維持されていましたが、生成された実装コードは依然として人間または別モデルによるレビューが必要という結果です。
追加Bonsai試験は元の点数と単純比較できない
ここは今回の検証で重要な注意点です。
最初のBonsai 2とQwen3.8へ与えた共通課題と、後から省VRAM設定で再実行したBonsaiの質問は、要求内容はほぼ同じですが完全に同一のプロンプトではありません。
実際のPrompt token数は、
初回共通テスト系 : 約2,600 tokens
追加Bonsaiテスト : 1,349 tokens
となっています。
そのため、追加テストのコード品質が最初のBonsai回答より低かったとしても、
「Q4 KVに変更したため能力が低下した」
と結論づけることはできません。
今回の追加試験から言えるのは、
65K / 1 slot / Q4 KV / Visionなしで約9.9GBまでVRAMを削減した状態でも、保存互換性など課題の核心は正しく認識でき、35K tokens以上の長文回答を約58 tok/sで生成できた。ただし実装コードにはレビューが必要な問題が複数残った。
というところまでです。
Bonsai 2とQwen3.8の実行効率を改めて比較
| 項目 | Bonsai 2 27B | Qwen3.8-27B |
|---|---|---|
| 量子化 | PQ2_0 | UD-IQ3_S |
| Context | 65,536 | 65,536 |
| slots | 1 | 1 |
| KV cache | Q4_0 | Q4_0 |
| Vision | なし | なし |
| 起動直後VRAM | 9,859 MiB | 14,370 MiB |
| 生成中VRAM | 9,896 MiB | 14,388 MiB |
| 生成速度 | 57.81 tok/s | 45.29 tok/s |
この条件では、Bonsai 2はQwen3.8より約4.5GB少ない総VRAMで生成できています。
生成速度も約28%高速です。
同じ27Bクラスを16GB GPUで運用する場合、この差はかなり大きいです。
公式の「98.2%維持」と今回の結果は矛盾する?
PrismMLはBonsai 2について、フル精度Qwen3.8-27Bに対して総合ベンチマーク性能の98.2%を維持するとしています。
一方、今回の共通WPF課題では、独自評価が、
Qwen3.8-27B  : 約8.2 / 10
Bonsai 2     : 約6.2 / 10
となりました。
これは公式結果と直接矛盾するものではありません。
PrismMLの98.2%は、Reasoning、Math、Coding、Instruction Following、Vision、Agentic Tool Useなど複数のベンチマークを集計した数値です。
一方、今回のテストは、
既存仕様を読み、保存互換性、WPF Binding、非同期処理、Command通知、単体テストまで一つの回答で一貫させる
という、かなり限定された実務寄りの課題です。
さらに今回比較したQwen3.8もフル精度ではなくUD-IQ3_S量子化版です。
そのため、今回の結果はこの種類のC#/WPF設計課題ではこれだけ差が出たという一つの実測として捉えるのが適切です。
RTX 5070 Ti 16GBならどちらを使う?
今回の結果から、筆者環境では用途を分けるのが最も実用的だと感じました。
普段の開発相談:Bonsai 2 27B
Bonsai 2の利点は明確です。
- 65K Contextでも約9.9GBで起動・生成可能
- 約58 tok/sで高速
- 27Bクラスの広い設計理解
- 旧Qwen3-14Bより複雑な条件を考慮できた
- 16GB GPUでも約6GBのVRAM余力を残せる
何度も会話しながらコードを修正する普段使いでは、この速度とVRAM余裕はかなり魅力的です。
ただし生成されたコードは、そのままコピーするのではなくレビュー前提で使いたいモデルです。
重要変更の最終レビュー:Qwen3.8-27B
Qwen3.8はBonsaiより重く、今回の環境では約14.4GBのVRAMを使用しました。
生成速度も約45 tok/sと遅くなります。
その代わり、今回のWPF課題では、
- 保存互換性
- enum数値
- 非同期競合
- 多重実行
- 自己レビュー
といった細部でBonsaiより高い精度を示しました。
「この変更は壊したくない」という場面の最終レビューには、Qwen3.8を使いたいという結果です。
27Bだから14Bより重いとは限らない
今回もう一つ興味深かったのは、パラメータ数だけではローカルLLMの実行負荷を判断できないことです。
旧Qwen3-14B Q5_K_Mは、40,960 Context・Q4 KVで約13.7GBのVRAMを使用しました。
一方、27BクラスのBonsai 2は、65,536 Context・1 slot・Q4 KVという条件でも約9.9GBで動作しています。
もちろんモデル世代や量子化方式、Attention構成、Context、KV cacheなどの条件が異なるため、単純な14B対27B比較ではありません。
しかし少なくとも、
14Bなら軽い、27Bなら16GB GPUでは無理
という単純な判断が通用しにくくなっていることは実感できました。
8GB・12GB GPUではどうか
今回の65K・1 slot・Q4 KV設定では、Bonsai 2の総VRAM使用量は約9.9GBでした。
そのため、同じ条件を8GB GPUへそのまま持ち込むのは難しいと考えられます。
一方、Contextを16Kや32Kへ下げる、より小さいPTQ1_0を利用するなどの調整を行えば必要VRAMをさらに削減できます。
12GB GPUなら、Text用途・Context調整込みでかなり現実的な候補になりそうです。
今回のように65K Contextまで余裕を持って扱う用途では、16GB VRAMはかなり使いやすいラインでした。
まとめ
今回、RTX 5070 Ti 16GBでBonsai 2 27B、Qwen3-14B、Qwen3.8-27Bを実際に比較しました。
同一のWPF設計課題に対する回答品質は、今回の独自評価では、
Qwen3.8-27B   約8.2 / 10
Bonsai 2 27B  約6.2 / 10
Qwen3-14B     約3.0 / 10
という結果でした。
Qwen3.8は保存互換性や非同期処理など細部まで最も正確でした。
Bonsai 2は細かいコードミスが残るものの、旧14Bモデルより考慮範囲が広く、27Bクラスらしい設計能力を確認できました。
そして実行効率については、条件を揃えた測定で、
Bonsai 2
65K / 1 slot / Q4 KV
生成中 約9.9GB
57.81 tok/s

Qwen3.8
65K / 1 slot / Q4 KV
生成中 約14.4GB
45.29 tok/s
となりました。
約4.5GB少ないVRAMで、約28%高速。
これが今回のBonsai 2で最も印象的だった結果です。
Bonsai 2は、「Qwen3.8と完全に同じ能力を小さくしたモデル」ではありませんでした。
しかし、かなりの27B級能力を残しつつ、16GB GPUで大きなVRAM余裕と高速な生成を実現しています。
筆者環境では、現時点では次の使い分けが最もしっくりきます。
Bonsai 2 27B:普段使いの高速・省VRAMな27BローカルLLM
Qwen3.8-27B:速度とVRAMを使ってでも精度を優先する最終レビュー用
RTX 5070 Ti 16GBのような環境でローカルLLMを使う場合、Bonsai 2 27Bはかなり面白い選択肢だと思います。
参考情報
- PrismML「Introducing Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint」
- PrismML-Eng「Bonsai-demo」
- Qwen「Qwen3.8-27B」公式モデルカード
- Unsloth「Qwen3.8-27B-GGUF」
コメント